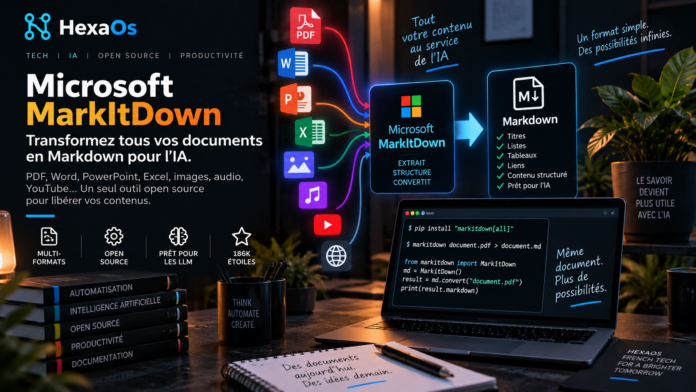
Un PDF, un document Word, une présentation PowerPoint, un fichier Excel, une image ou même une URL YouTube : MarkItDown, le projet open source de Microsoft, transforme ces contenus en Markdown exploitable par les outils d’analyse et les modèles d’IA. Le dépôt a désormais franchi le cap des 186 000 étoiles sur GitHub, un niveau qui montre l’intérêt considérable suscité par le projet.
L’idée en une phrase : MarkItDown ne cherche pas à reproduire visuellement un document. Il cherche à en extraire le contenu et sa structure dans un format simple, lisible et facilement exploitable par une chaîne d’analyse ou un LLM.
Le problème n’est pas le PDF. C’est ce qu’il y a à l’intérieur.
Les systèmes d’IA savent travailler avec du texte. Le problème apparaît lorsqu’on leur fournit des informations enfermées dans des formats conçus avant l’ère des LLM : documents Word, tableaux Excel, présentations PowerPoint, PDF ou pages Web.
Il faut alors passer par une étape d’extraction et de normalisation. C’est précisément là que MarkItDown intervient.
Le projet officiel de Microsoft est présenté comme un outil Python et une interface en ligne de commande capables de convertir différents formats vers Markdown, notamment pour l’indexation, l’analyse de texte et les pipelines utilisant des LLM.
De nombreux formats derrière une seule sortie
MarkItDown prend en charge plusieurs familles de contenus. La documentation officielle mentionne notamment :
- Word / DOCX
- PowerPoint / PPTX
- Excel / XLSX
- images, avec métadonnées et possibilités d’analyse
- audio, avec transcription selon la configuration utilisée
- HTML
- CSV, JSON et XML
- fichiers ZIP
- EPUB
- certaines sources Web et URL YouTube, avec les dépendances appropriées.
Le support exact dépend toutefois des convertisseurs et des dépendances optionnelles installés. Il ne faut donc pas confondre « format pris en charge » avec « conversion parfaite dans tous les cas ».
Pourquoi du Markdown ?
C’est probablement le point le plus intéressant du projet.
Microsoft explique que Markdown est suffisamment proche du texte brut pour rester léger, tout en permettant de conserver des éléments essentiels de la structure documentaire : titres, listes, tableaux, liens et organisation du contenu.
Pour une chaîne IA, cette représentation est beaucoup plus intéressante qu’une simple extraction de texte brut.
Document original
PDF / DOCX / PPTX / XLSX / HTML / image
↓ extraction
MarkItDown
conversion et restructuration du contenu
↓
Markdown structuré
↓
LLM / RAG / recherche documentaire / analyse / automatisation
Sous le capot : ce n’est pas qu’un simple convertisseur
MarkItDown s’appuie sur différents convertisseurs spécialisés. Le code du projet contient notamment des composants dédiés aux PDF, DOCX, XLSX, PPTX, images, audio, HTML, CSV, EPUB, ZIP et YouTube.
L’intérêt de cette architecture est de pouvoir traiter chaque format selon ses particularités avant de produire une représentation Markdown commune.
Le projet accepte également des plugins tiers. Ces extensions peuvent ajouter des capacités de conversion sans modifier directement le dépôt principal.
Et l’OCR dans tout ça ?
C’est l’un des développements les plus intéressants du projet.
Microsoft propose désormais un plugin markitdown-ocr capable d’extraire le texte présent dans des images intégrées à des PDF, documents Word, présentations PowerPoint et fichiers Excel.
Le plugin peut utiliser un modèle de vision compatible avec l’API OpenAI pour analyser ces images. Pour les PDF scannés, sa documentation décrit également un mécanisme de reconnaissance de texte sur les pages rendues comme images.
Le changement important : un document scanné ou contenant des informations uniquement sous forme d’image peut ainsi entrer dans une chaîne d’analyse beaucoup plus facilement qu’avec une simple extraction textuelle classique.
Quelques lignes pour commencer
Le projet peut être utilisé directement depuis Python ou depuis le terminal.
Puis, pour convertir un PDF :
L’utilisation Python reste tout aussi simple :
Le vrai intérêt : préparer les documents pour les systèmes d’IA
MarkItDown devient particulièrement intéressant lorsqu’il est placé au milieu d’un pipeline.
Imaginez une entreprise qui reçoit plusieurs centaines de documents : contrats, rapports, factures, procédures internes ou présentations.
Au lieu de transmettre directement chaque fichier à un modèle d’IA, une première étape peut consister à extraire et normaliser leur contenu. Le Markdown produit peut ensuite alimenter un moteur de recherche, une base documentaire, un système RAG ou un agent IA.
Une chaîne documentaire possible
01 — Collecte des documents
02 — Extraction avec MarkItDown
03 — Normalisation en Markdown
04 — Indexation
05 — Recherche ou RAG
06 — Exploitation par un modèle d’IA
Mais attention : Markdown ne signifie pas conversion parfaite
C’est ici qu’il faut éviter le discours marketing.
MarkItDown n’a pas pour objectif principal de recréer fidèlement l’apparence originale d’un document. Microsoft précise que le projet vise avant tout les outils d’analyse de texte et que le résultat peut ne pas convenir lorsqu’on recherche une conversion visuelle haute fidélité.
Un document PowerPoint très graphique, un PDF avec une mise en page complexe ou un fichier contenant des éléments visuels fortement imbriqués peut donc nécessiter une vérification humaine ou une autre chaîne de traitement.
À retenir : MarkItDown optimise la récupération et la structuration du contenu pour l’analyse. Il ne faut pas le considérer comme un outil de PAO chargé de reproduire pixel par pixel le document original.
Un outil puissant, mais à ne pas exposer n’importe comment
Le dépôt officiel contient également une section consacrée à la sécurité. Microsoft précise que MarkItDown effectue les opérations d’entrée/sortie avec les privilèges du processus qui l’exécute.
Cela signifie qu’une application serveur qui accepte des fichiers ou des URL fournis par des utilisateurs doit valider et restreindre les entrées avant de les transmettre au convertisseur.
Microsoft recommande notamment de limiter les chemins de fichiers, les schémas URI, les destinations réseau et l’accès à certaines adresses privées ou sensibles selon le contexte de déploiement.
Autrement dit : installer MarkItDown sur une machine personnelle pour convertir ses propres documents n’est pas le même scénario que construire un service Web public qui accepte des fichiers provenant d’inconnus.
Le projet va plus loin avec MCP
Microsoft fournit également un serveur MCP basé sur MarkItDown. L’objectif est de permettre à des applications compatibles avec le Model Context Protocol d’utiliser la conversion documentaire comme un outil.
Mais là encore, la sécurité devient centrale : la documentation du serveur MCP indique qu’il fonctionne avec les privilèges de l’utilisateur qui l’exécute et recommande notamment de rester sur localhost ou de mettre en place un environnement isolé lorsque le scénario l’exige.
Pourquoi 186 000 étoiles sont intéressantes
Le nombre d’étoiles ne constitue évidemment pas une mesure de qualité technique à lui seul. Mais avec environ 186 000 étoiles et plus de 13 000 forks sur GitHub au moment de notre vérification, MarkItDown est devenu un projet particulièrement visible dans l’écosystème open source lié à l’IA.
Ce succès raconte surtout quelque chose sur le problème auquel il répond : les entreprises et les développeurs ont besoin de transformer leurs documents existants en données réellement exploitables par les nouveaux outils d’IA.
L’analyse HEXAOS
MarkItDown n’est pas une IA qui « comprend » magiquement tous les documents. C’est une pièce d’infrastructure documentaire.
Et c’est justement ce qui le rend intéressant.
Dans beaucoup de projets IA, l’attention se concentre sur le modèle : quel LLM utiliser, quelle taille, quel contexte, quel agent. Pourtant, la qualité du système dépend aussi fortement de ce qui arrive avant le modèle.
Si un contrat, un tableau, une présentation ou un PDF scanné est mal extrait, le meilleur LLM du monde travaillera sur une représentation incomplète du document.
MarkItDown s’attaque précisément à cette couche : transformer des formats documentaires hétérogènes en une représentation textuelle structurée et exploitable.
MarkItDown est intéressant moins pour son effet « convertisseur universel » que pour sa place dans une chaîne moderne de traitement documentaire. Son intérêt apparaît lorsqu’il sert de passerelle entre des documents conçus pour les humains et des systèmes d’IA qui ont besoin d’un contenu structuré. Son principal point de vigilance reste le même que pour toute couche d’ingestion : qualité de l’extraction, limites de conversion et sécurité des entrées doivent être vérifiées selon le cas d’usage.